728x90

이번 주 파이토치 콘퍼런스 북미(10/20~21) 행사장에서 가장 주목받은 뉴스는 모델 발표가 아니었다. 구글과 AWS가 각각 자사 AI 칩에 파이토치를 '네이티브'로 올리는 백엔드를 공개했다. 모델이 아니라 인프라의 이야기다.


## 파이토치, 이제 엔비디아 칩이 없어도 된다


구글이 자사 TPU에서 파이토치가 "원래 지원되던 것처럼" 동작하게 하는 오픈소스 백엔드 '토치TPU(TorchTPU)'를 공식 확인했다(The Stack). AWS도 자사 AI 칩 트레이니엄에서 파이토치 코드를 수정 없이 그대로 돌리는 네이티브 백엔드 '토치뉴런(TorchNeuron)'을 공개했다(베타·오픈소스, PyTorch Blog 발표). 지금까지 사실상 엔비디아 CUDA에 묶여 있던 AI 개발의 선택지를 넓히려는 시도다.


"모델을 돌리려면 엔비디아 칩"이라는 전제가 흔들리기 시작했다.


## 장부 숫자는 진짜다 — 슈퍼마이크로, 전망 40억 달러 상향


AI 서버 제조사 슈퍼마이크로가 SEC 공시에서 지난 분기(9월 말 종료) 매출을 185억~195억 달러로 추정했다. 기존 가이던스(145억~155억 달러)보다 약 40억 달러 높은 수치로, 이유는 AI 플랫폼 수요 급증이다. 정식 실적 발표는 11월 3일 예정이다. 모델의 파라미터 수 논쟁과 달리, 인프라 수요는 장부 숫자로 보인다. 숫자는 거짓말을 안 한다.


## 7년차 현장 엔지니어로서 한 줄


현장에서 AI 프로젝트의 생사를 가르는 건 '어떤 모델을 쓰느냐'가 아니라 '그 모델을 어디서, 얼마나 싸고 안정적으로 돌리느냐'다. 클라우드 GPU 요금에 허덕이다 프로젝트가 멈추는 걸 여러 번 봤다. CUDA 종속이 풀리면 엣지와 온프레미스의 선택지가 넓어지고, 공장의 AI는 그때부터 비로소 '현실 가격'이 된다.


## 다음 전쟁의 점수판


AI 경쟁의 무게중심이 '모델'에서 '실행 인프라'로 이동하고 있다. 앞으로 주목할 지표는 모델의 파라미터 수가 아니라 칩·프레임워크 호환성과 실제 운영 비용이다. 현장에 서 있는 사람에게는 후자가 훨씬 중요한 뉴스다.


---


출처: PyTorch Blog(AWS TorchNeuron), The Stack(구글 TorchTPU 공식 확인), SEC 8-K 공시(슈퍼마이크로 분기 매출 전망 상향) — 2026년 10월 21일 기준.

728x90
728x90

> **[합성 데이터로 훈련하는 제조 AI] 시리즈 4편.** 1편 '불량 데이터가 없어서 못 만드는 제조 AI — 합성 데이터로 훈련하는 법', 2편 '시뮬레이션에서 배운 AI, 공장에서 살아남는 법 — 현장 검증 3단계', 3편 '검증 통과한 AI가 한 달 만에 틀리기 시작했다 — 데이터 드리프트와 재학습 루프'에 이어, 이번 4편에서는 가장 값싸고 가장 자주 버려지는 데이터를 다룹니다. '현장의 한마디'입니다.


---


3편에서 이런 말을 했습니다. "드리프트를 잡는 가장 빠른 센서는 현장 작업자다. '요즘 알람이 좀 이상해요'라는 말은 지표가 무너지기 2~3주 전에 먼저 온다." 그런데 그 한마디는 보통 회의에서 증발합니다. 기억 속에, 메신저 방에, 점심시간 농담으로. 7년차 현장 엔지니어로서 단언합니다. 작업자 피드백을 합성 시나리오로 바꾸는 루프가 없는 팀은, 드리프트가 와도 "알고는 있었는데"가 됩니다. 이번 4편에서는 현장의 한마디를 파이프라인의 입력으로 바꾸는 실전 루프를 소개합니다.


## 1. 피드백은 '감'이 아니라 '데이터 카드'다


현장의 한마디는 감이 아닙니다. "조금 이상해요"를 그대로 받아적으면 데이터가 되지 않습니다. 피드백 카드 네 줄로 바꾸세요.


- **언제:** 시간대와 교대 (오후 3시 이후, 야간 2교대 등)

- **어디서:** 설비와 카메라 ID (라인 번호, 셀 번호)

- **무엇이:** 판정의 어긋남 (정상인데 불량 알람 / 불량인데 통과 / 판정이 들쭉날쭉)

- **조건:** 그때의 환경 (조명, 날씨, 작업자 교대, 소재 로트)


이 네 줄이 있으면 합성 시나리오의 '조건 파라미터'로 바로 변환됩니다. 예를 들어 "오후 3시 이후 서쪽 창가 라인에서 정상품에 긁힘 알람이 잦음"이라는 카드는 합성 시나리오 "오후 시간대 직사광선 각도 + 해당 소재 질감의 미세 긁힘"이 됩니다. 피드백을 카드로 바꾸는 순간, 감은 설계 입력이 됩니다. 양식 한 장이면 충분합니다. 종이든 스프레드시트든 HMI 입력폼이든, 카드가 '쌓이는' 형태라면 됩니다.


## 2. '재확인 버튼'을 라인 옆에 둔다


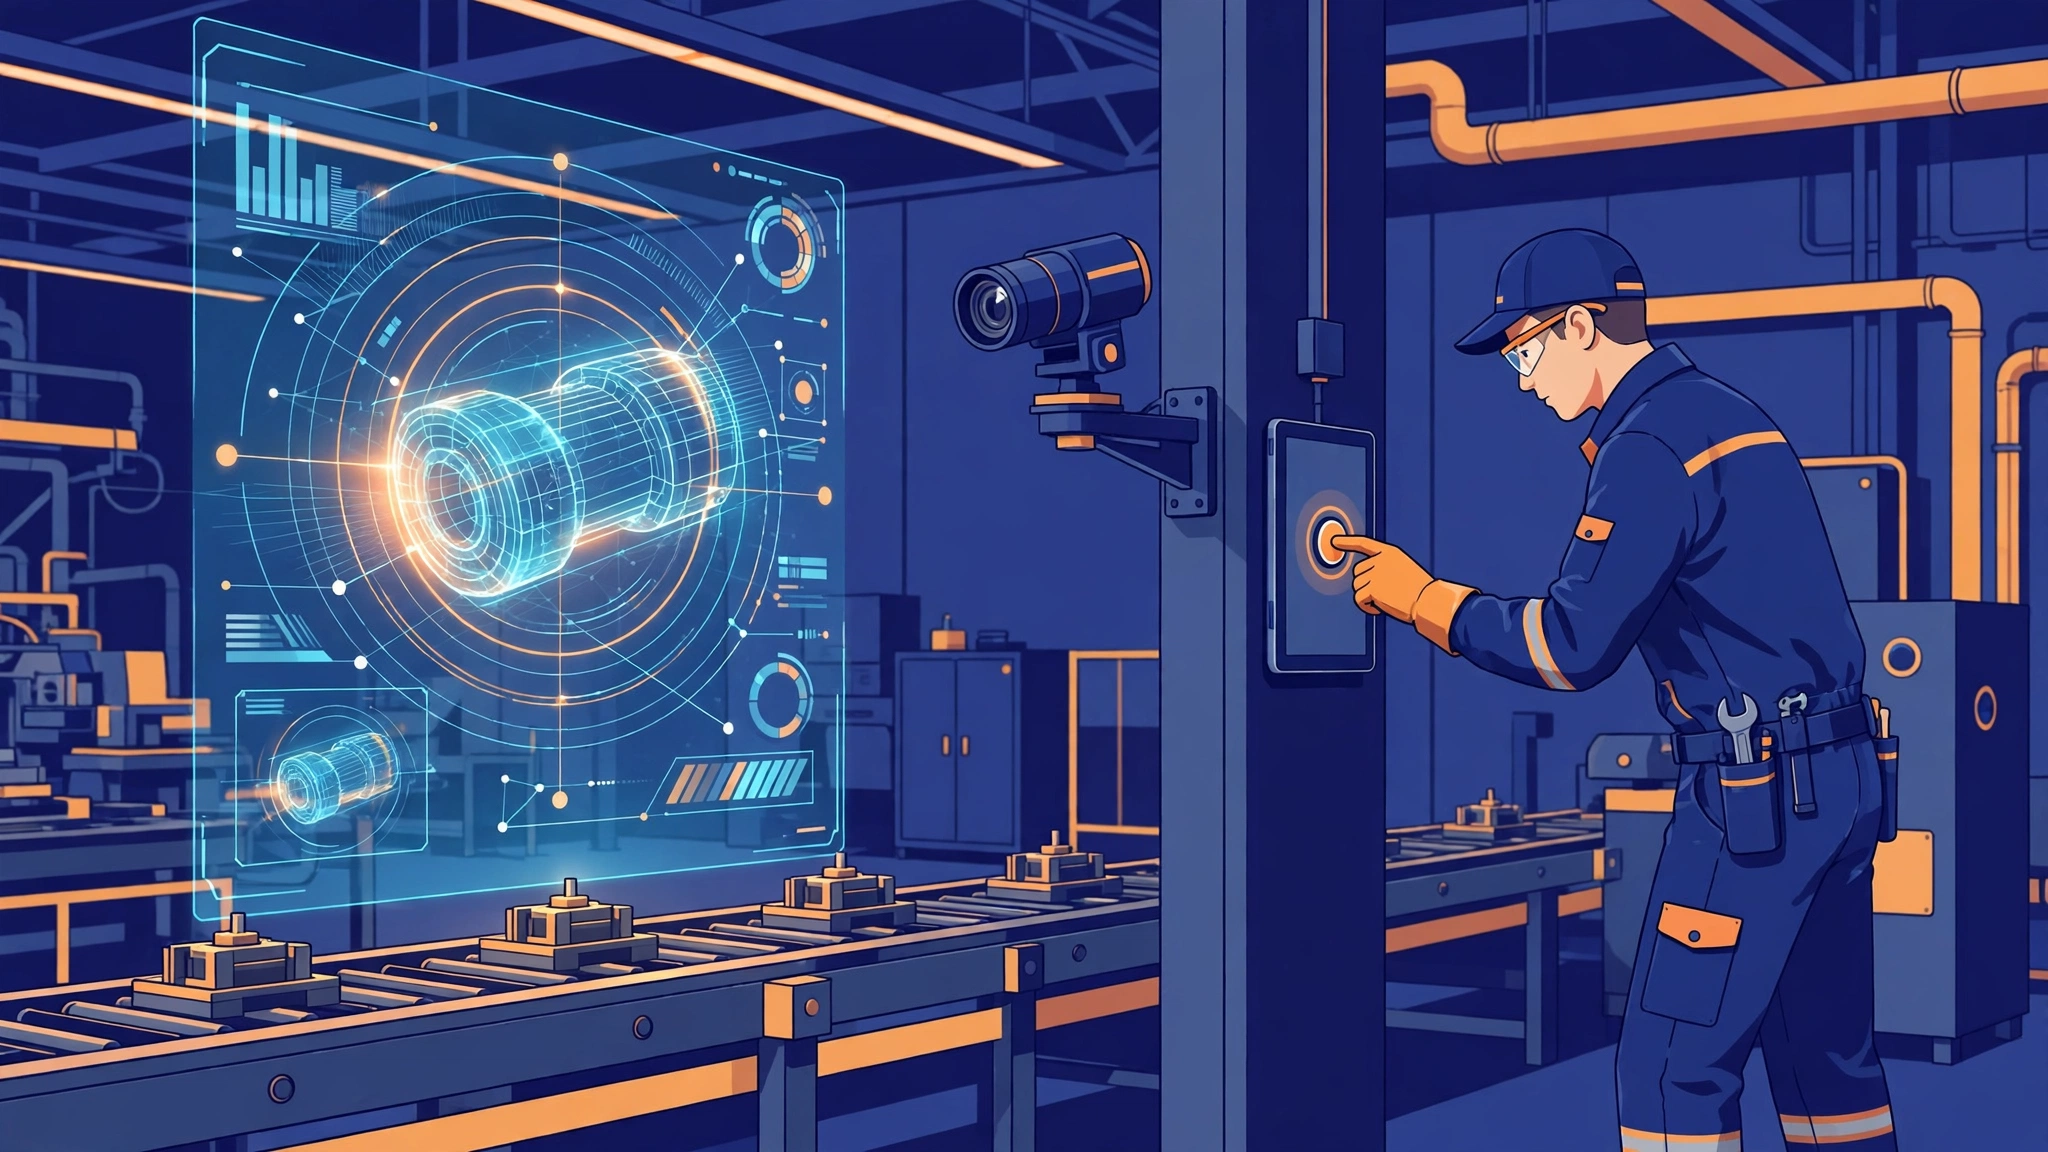
피드백이 오려면 경로가 있어야 합니다. 작업자 HMI나 라인 옆 태블릿에 'AI 판정 재확인' 버튼을 하나 두세요. 작업자가 AI 판정을 뒤집는 순간, 이미지·확률·뒤집힌 이유(간단 선택: 오탐/미탐/모호함)가 자동으로 저장됩니다. 이 로그가 쌓이면 '틀린 케이스 풀'이 생깁니다.


2편에서 파일럿의 틀린 케이스가 가장 비싼 학습 데이터라고 했습니다. 운영 단계에서도 구조는 똑같습니다. 월 1회, 그 풀을 리뷰해서 합성 시나리오로 추가하세요. "이번 달 이런 조건의 틀림이 37건"처럼 우선순위까지 자동으로 붙습니다. 작업자는 추가 업무를 느끼지 않고, AI 팀은 매달 가장 아픈 케이스를 시나리오로 돌려받습니다. 현장이 AI를 가르치는 구조, 이게 그 실체입니다.


## 3. 시나리오 라이브러리도 버전 관리가 필요하다


피드백이 시나리오로 바뀌기 시작하면, 다음 문제는 '시나리오 부채'입니다. 그대로 쌓아두면 반년 뒤 아무도 모르는 시나리오가 됩니다. "이거 왜 만든 거지?" — 이 질문이 나오기 시작하면 파이프라인은 죽어가고 있는 겁니다.


방법은 단순합니다. 모든 시나리오에 출처 태그를 붙이세요. 피드백 카드 번호, 날짜, 설비 ID. 그러면 설비가 교체되거나 공정이 바뀔 때, 관련 시나리오를 '검토 필요'로 바꿀 수 있습니다. 조건이 사라진 시나리오는 은퇴시키고, 반복되는 틀림은 시나리오로 승격시킵니다. 합성 파이프라인도 소프트웨어입니다. 버전 없는 파이프라인은 언젠가 "왜 이 시나리오가 있는지 아무도 몰라"가 됩니다.


## AI를 가르치는 건 합성 엔진이 아니라 현장의 매일이다


합성 데이터는 '데이터가 없어서 못 한다'는 핑계를 없앴고, 검증 루프는 '가상에서는 됐는데'라는 핑계를 없앴고, 드리프트 감시는 '처음엔 됐는데'라는 핑계를 없앴습니다. 남은 핑계는 "현장이랑 안 맞아"입니다. 이걸 없애주는 게 오늘 4편의 루프 — 피드백 카드, 재확인 버튼, 시나리오 버전 관리입니다.


그래서 뭘 하면 되나 — 라인 옆 태블릿에 재확인 로그 양식(버튼이든 종이 카드든) 하나를 오늘 만드세요. 그리고 다음 주 월요일 아침, 지난주에 뒤집힌 판정 10건을 뽑아 합성 시나리오 카드로 바꿔보세요. AI를 가르치는 건 합성 엔진이 아니라, 현장의 매일입니다.


---

관련 글:

- [합성 데이터로 훈련하는 제조 AI] 3편 — 검증 통과한 AI가 한 달 만에 틀리기 시작했다 (https://developer-archive.tistory.com/133)

- [디지털트윈의 진짜 엔진은 3D가 아니라 '데이터 수집'이다](https://developer-archive.tistory.com/124) — 수집이 합성 시대에도 여전히 필요한 이유.


*다음 5편: '합성 데이터 시리즈 최종회 — 현장 도입 전 실전 체크리스트 20'에서 이어집니다.*

728x90
728x90

**"오피씨 유 에이는 기종이 달라도 기계를 묶는 통신 규약이에요."** 오늘 아침 쇼츠 '제조AI 용어 사전 EP.3'의 한 문장 요약이다. 30초에서는 맛만 봤으니, 블로그에서는 7년차 현장 엔지니어 관점으로 제대로 풀어 보자. OPC UA가 뭔지, 왜 구형 OPC와 다른지, 현장에서 언제 필요한지, 그리고 어떻게 손대면 좋은지까지.


## 1. 공장의 '바벨탑' 문제 — 기계마다 말이 다르다


공장 라인을 세우다 보면 같은 설비 이야기를 하는데 언어가 다 다르다. 일본산 로봇은 CC-Link, 유럽산 장비는 PROFINET, 미국산은 EtherNet/IP, 오래된 설비는 Modbus. MES에서 생산 데이터를 끌어오려고 하면 프로토콜마다 어댑터를 따로 개발해야 한다. 이걸 다 직접 붙이면 통합 비용이 눈덩이처럼 불어난다.


옛날 방식의 해결책이 OPC DA였다. "하나의 중간 번역기만 두자"는 아이디어였고, 실제로 한동안 현장에서 통했다. 그런데 OPC DA는 윈도우의 COM/DCOM 기술 위에 올라가 있었다. 윈도우 아니면 안 돌아가고, 공장망에 보안 구멍을 여는 구조적 약점도 있었다. 2000년대에는 괜찮았지만, 요즘처럼 리눅스 기반 엣지 장비가 늘고 사이버 보안이 화두인 시대에는 한계가 뚜렷하다.


## 2. OPC UA가 다른 세 가지


OPC UA(Unified Architecture)는 OPC DA의 후계자로, 처음부터 다시 설계된 통신 표준이다. 현장에서 체감되는 차이는 세 가지다.


**첫째, 플랫폼 독립.** 윈도우든 리눅스든 임베디드든 다 돌아간다. 소켓 기반 통신이라 OS에 갇히지 않는다. 요즘 엣지 게이트웨이나 리눅스 IPC가 늘어나면서 이게 제일 크게 와닿는다.


**둘째, 정보 모델(Information Model).** OPC UA는 데이터만 주고받는 게 아니라, "이 설비가 어떤 데이터를 어떤 구조로 가지고 있다"는 설계도까지 표준 형식으로 주고받는다. 주소 공간(Address Space) 안에 노드(Node)라는 단위로 온도·압력·상태 같은 데이터를 표준 구조로 표현하는 거다. 그래서 처음 붙일 때 장비 스펙을 뜯어보는 수고가 확 준다.


**셋째, 보안 내장.** 인증서 기반 인증과 통신 암호화가 표준에 들어 있다. 공장망이 인터넷과 연결되는 일이 잦아진 지금, "통신 자체는 암호화 안 됐는데 방화벽 뒤라서 괜찮다"는 식의 운영은 더 이상 통하지 않는다.


비교표로 정리하면 이렇다.


| 항목 | OPC DA (구형) | OPC UA | Modbus TCP |

|---|---|---|---|

| 기반 기술 | COM/DCOM | 소켓 (TCP) | TCP |

| 플랫폼 | 윈도우 종속 | 독립 | 독립 |

| 보안 | 없음 (취약) | 인증서·암호화 내장 | 없음 |

| 데이터 모델 | 단순 값 전달 | 정보 모델 (구조 표준화) | 레지스터 주소 |

| 적합 용도 | 구형 윈도우 시스템 | 통합 게이트웨이·디지털트윈 | 단순 설비·저비용 |


## 3. 현장에서 OPC UA가 필요한 순간


내 경험상 OPC UA를 도입하게 되는 건 보통 세 가지 타이밍이다.


**서로 다른 벤더 장비를 하나로 묶을 때.** 로봇·PLC·센서가 전부 다른 메이커면, OPC UA 게이트웨이 하나로 통합하는 게 어댑터 5개 만드는 것보다 싸고 안정적이다.


**디지털트윈을 만들 때.** 지난 EP.2에서 디지털 스레드를 "제품의 일생을 꿰는 실"이라고 했다. 그 실을 현장에서 실제로 꿰는 바늘이 OPC UA다. 트윈에 들어가는 실시간 데이터의 표준 통로로 가장 많이 쓰인다.


**설비 데이터를 클라우드·AI 쪽으로 올릴 때.** 예지정비 모델(EP.1)을 돌리려면 설비 데이터가 안정적으로 올라와야 한다. 암호화된 표준 통로가 있으면 IT팀 설득도 훨씬 쉽다.


실무 팁 하나. 도입 전에 **자사 설비가 OPC UA 서버를 지원하는지부터 확인**하자. 요즘 PLC·로봇 컨트롤러는 대부분 내장하고 있지만, 10년 넘은 설비는 게이트웨이가 필요하다. 그리고 정보 모델 설계에 시간을 써라. 노드 구조를 설비 종류별로 통일해두지 않으면, 나중에 데이터 분석할 때 "같은 온도인데 노드 경로가 라인마다 다르다"는 지옥을 만난다.


## 4. 손대보는 방법 — Python 한 줄로 붙여보기


거창하게 시작할 필요는 없다. 현장에 OPC UA 지원하는 설비가 하나라도 있다면, 노트북에서 Python으로 바로 붙여볼 수 있다. `asyncua` 라이브러리 하나면 클라이언트가 된다.


```python

from asyncua import Client


async def read_temp():

    # 예시 주소: 실제 설비의 OPC UA 서버 주소로 교체

    async with Client("opc.tcp://192.168.0.10:4840") as c:

        node = c.get_node("ns=2;i=2001") # 설비 온도 노드

        print(await node.read_value())

```


서버가 살아 있고 네트워크만 열려 있으면 이 몇 줄로 설비의 온도 값을 읽는다. "기종이 달라도 기계를 묶는다"는 게 바로 이 감각이다. 설비 쪽 프로토콜이 뭔지는 이제 신경 안 써도 된다.


---


OPC UA는 멋진 신기술이 아니라, 공장의 바벨탑을 정리하는 표준 언어다. EP.1 예지정비의 데이터가 흐르고, EP.2 디지털 스레드의 실이 꿰어지려면, 현장에서는 이런 표준 통로가 먼저 깔려 있어야 한다. 다음 EP에서는 '가상 커미셔닝(Virtual Commissioning)'을 다룬다. 쇼츠에서 30초로, 블로그에서 깊이 있게. 시리즈로 따라오면 제조AI 용어가 하나씩 내 것이 된다.

728x90
728x90

오늘 점심 쇼츠에서 메타송이가 밈으로 풀어낸 한마디, "다시 켜봤어요?" 사실 이건 농담이 아니라 현장의 공식 절차 1번입니다. 멈춘 로봇 앞에서도, 먹통이 된 HMI 앞에서도 제일 먼저 나오는 말이 "재부팅 한 번 해볼까요?"거든요. 7년차 현장 엔지니어로서 고백하자면, 저도 셀 수 없이 많이 눌렀습니다. 그런데 재부팅이 통할 때와 안 통할 때가 갈립니다. 그 경계를 아는 게 장애 대응의 시작입니다.


## 재부팅이 통하는 이유 — '상태'의 문제일 때


현장의 많은 장애는 고장이 아니라 '상태 꼬임'입니다. 누적된 카운터, 풀리지 않은 소켓, 메모리 누적으로 버벅이는 HMI, 한 번 어긋나서 돌아오지 않는 시퀀스 플래그. 전원을 껐다 켜면 이 임시 상태가 초기화되니까 당연히 잘 됩니다. 재부팅은 증상 치료제로서는 훌륭하고, 빨리 돌려야 하는 라인에서는 정답이기도 합니다.


## 재부팅으로 안 되는 장애 3가지


문제는 재부팅이 '증상'만 지운다는 겁니다. 제 경험상 재부팅 후에도 돌아오는 장애는 셋 중 하나였습니다.


첫째, 하드웨어 문제. 센서가 드리프트되면 아무리 껐다 켜도 같은 값으로 어긋납니다. 둘째, 통신 문제. 케이블 단선이나 노이즈로 끊긴 Modbus·OPC UA 세션은 재부팅 순간엔 붙었다가 부하가 오르면 또 끊깁니다. 셋째, 데이터·로직 문제. 래더에 숨어 있는 카운터 오버플로우나 조건 하나 빠진 인터락은 재부팅해도 같은 조건에서 정확히 재현됩니다. 실제로 협동로봇이 멈췄던 날, 디지털트윈의 부하 데이터를 보니 재부팅 후 같은 동작 구간에서 과부하가 반복되더군요. 껐다 켜는 건 답이 아니었습니다.


## 7년차의 장애 대응 루틴 4단계


그래서 저는 장애 앞에서 이 순서를 지킵니다. ① 증상 기록 — 몇 시에, 어떤 동작 중에, 어떤 에러 코드로 멈췄는지. 기억은 휘발되지만 메모는 남습니다. ② 로그 확인 — 알람 이력과 트렌드 데이터를 봅니다. ③ 재현 조건 좁히기 — 같은 동작에서 반복되는지, 특정 시간대에만 나오는지. ④ 원인 분류 — 기계·전기·통신·소프트웨어 중 어디인지 먼저 찍고 파고듭니다. 그리고 무엇보다, 손대기 전에 백업. 이건 철칙입니다.


관련 글: 디지털트윈이 '실시간'이 되는 조건 — 샘플링·지연시간·동기화 설계하기 (https://developer-archive.tistory.com/132)


---


재부팅은 응급처치이고, 진단은 습관입니다. 다음에 "다시 켜봤어요?"라는 말이 나올 때 한 번만 더 물어보세요. "그래서, 왜 멈췄는데요?" 그 질문에 답할 수 있는 로그와 기록이 쌓이면, 그게 바로 현장 엔지니어의 실력입니다. 그래서 뭘 하면 되나 — 오늘부터 장애 날 때마다 '시간·동작·에러코드' 세 줄만 메모해 보세요.

728x90
728x90

한국이 글로벌 AI 최상위 그룹에 처음으로 이름을 올렸다. 보스턴컨설팅그룹(BCG)이 10월 20일 발표한 'AI 성숙도 매트릭스 2026'에서 한국을 미국·중국·영국·싱가포르·캐나다와 함께 'AI 선도국(AI Pioneers)'으로 분류한 것이다. 2024년 첫 조사 이후 단 2년 만의 도약이다. 수치 뒤에 숨은 의미를, 제조 현장에서 AI를 돌려본 사람의 눈으로 풀어본다.


"AI 선도국"이 되기까지, 뭐가 달라졌나


BCG는 전 세계 75개 이상 경제권을 대상으로 AI의 잠재적 영향인 'AI 노출도'와 이를 활용할 준비 수준인 'AI 준비도'를 평가한다. AI 준비도는 국가 목표·인재·정책·투자·연구·생태계 6개 영역으로 나뉘는데, 한국은 특히 자체 AI 모델 개발 역량과 컴퓨팅 인프라, 생태계 구축을 위한 공공투자에서 높은 점수를 받았다. 스탠퍼드 HAI의 '2026 AI 인덱스'에서도 '주목할 만한 AI 모델' 개발 부문 세계 5위권에 들었다.


눈에 띄는 건 함께 신규 진입한 나라가 일본이라는 점이다. 한국과 일본, 두 제조 강국이 나란히 최상위 그룹에 올라선 건 우연이 아니다.


BCG가 말한 진짜 메시지 — "전략은 끝났다, 실행이 남았다"


이번 보고서에서 BCG가 가장 강조한 대목은 따로 있다. 대부분의 경제권이 이미 AI 전략 수립 단계는 마쳤고, 이제는 전략을 실제 산업 경쟁력과 경제 성과로 얼마나 빠르게 연결하느냐가 국가 경쟁력을 가른다는 것이다.


7년차 현장 엔지니어로서 이 문장이 제일 와닿았다. 현장도 똑같다. PoC 데모는 화려하게 성공하는데 실제 라인에 올리면 한 달 만에 정확도가 무너지고, 결국 "AI는 됐고"라며 엑셀로 돌아가는 곳이 한둘이 아니다. 나라든 공장이든, 이제 경쟁은 '얼마나 빨리 현장에 붙이는가'의 싸움이다. 전략 문서가 아니라 생산성 지표가 답이다.


피지컬 AI — 제조 강국에게 온 기회


보고서는 AI의 영향권이 정보통신·금융 같은 지식산업에서 휴머노이드 로봇·산업 자동화 같은 피지컬 AI로 넓어지며 제조·물류·농업으로 확대될 것으로 전망했다. 그리고 한국에 대한 처방도 분명하다. 제조업 경쟁력과 산업 현장 데이터를 활용하면 인더스트리얼 AI·피지컬 AI에서 새로운 기회를 만들 수 있다는 것이다.


이게 왜 중요하냐면, LLM 경쟁은 자본 게임이지만 피지컬 AI는 데이터 게임이기 때문이다. 로봇 팔이 용접 토치를 어떻게 움직이는지, 불량 패턴이 설비 어느 구간에서 발생하는지 — 이런 현장 데이터는 공장을 가진 나라만 쌓을 수 있다. 한국이 디지털트윈을 현장에 붙이고, 합성 데이터로 훈련해야 하는 이유가 여기에 있다. 우리의 무기는 GPU 몇 장이 아니라, 지난 수십 년간 쌓인 생산 현장의 데이터와 도메인 지식이다.


물론 과제도 명확하다. BCG가 제시한 네 가지 — 글로벌 파트너십 확대, 컴퓨팅·전력·네트워크 인프라 확충, AI 전문인력 확보, 민간투자 촉진 정책 — 은 결국 "현장에 AI 인력이 얼마나 들어갈 수 있느냐"로 수렴한다. AI 선도국이라는 칭호보다 중요한 건, 다음 2년 안에 제조업 부가가치에서 AI가 얼마나 기여하느냐일 것이다.


(출처: BCG 'AI Maturity Matrix 2026' 보도 — 머니투데이 2026-10-20, 연합뉴스 2026-10-20)

728x90
728x90

[합성 데이터로 훈련하는 제조 AI] 시리즈 3편. 1편 '불량 데이터가 없어서 못 만드는 제조 AI — 합성 데이터로 훈련하는 법', 2편 '시뮬레이션에서 배운 AI, 공장에서 살아남는 법 — 현장 검증 3단계'에 이어, 이번 3편에서는 모델이 라인에 올라간 '다음 달'의 이야기를 다룹니다.


파일럿을 통과했습니다. 한 셀에서 3주 돌려 오탐·미탐 패턴을 잡고, 틀린 케이스는 합성 파이프라인에 다시 넣어 재학습까지 마쳤습니다. 본 라인에 올린 첫 주, 현장 반응은 좋았습니다. 그런데 한 달 뒤, 다시 전화가 왔습니다. "요즘 이거 좀 이상한데요?" 정확도 수치를 까보니 96%에서 89%로 내려와 있었습니다. 2편에서 다룬 '검증'을 다 통과한 모델인데, 왜일까요? 7년차 현장 엔지니어로서 말합니다 — 공장은 가만히 있는 세계가 아닙니다. 모델은 시간이 지나면서 공장과 어긋나고, 이 어긋남에는 이름이 있습니다. 데이터 드리프트(Data Drift)입니

다.


1. 시뮬레이션은 고정된 세계, 공장은 움직이는 세계


합성 데이터로 훈련하고 검증까지 마친 모델은 '그 시점의 공장'을 배운 겁니다. 문제는 그 시점이 오래가지 않는다는 것입니다. 제가 현장에서 본 드리프트의 얼굴은 대략 네 가지였습니다.


설비의 변화. 공구가 마모되면 절삭면의 질감이 바뀌고, 렌즈를 교체하면 화각과 색감이 바뀝니다. 모델이 배운 '정상'의 정의가 설비와 함께 늙어가는 셈입니다.


공정의 변경. 작업 순서가 바뀌거나 지그가 교체되면, 카메라에 들어오는 장면 자체가 달라집니다. 특히 불량의 '배경'이 바뀌면 모델의 판단 근거가 흔들립니다.


환경의 계절성. 여름철 직사광선이 작업대 각도를 바꾸고, 겨울철 난방으로 공기가 떨리면(열기류) 이미지가 미세하게 흔들립니다. 야간 조도와 주간 조도의 차이도 무시 못 합니다.


새로운 불량 유형. 신제품이 투입되거나 협력사가 바뀌면, 모델이 한 번도 본 적 없는 불량이 등장합니다. 이건 드리프트를 넘어 '미지의 세계'입니다.


시뮬레이션은 고정된 세계를 렌더링하지만, 공장은 매일 조금씩 다른 세계입니다. 검증은 출발선이지 종착선이 아닙니다.


2. 드리프트는 수치보다 먼저 '느낌'으로 온다


드리프트를 잡는 가장 빠른 센서는 의외로 현장 작업자입니다. "요즘 알람이 좀 이상해요"라는 말은, 지표가 무너지기 2~3주 전에 먼저 옵니다. 이 느낌을 흘려보내지 말고, 숫자로 붙잡는 루틴을 만드세요.


예측 분포의 이동을 본다. 모델이 매일 뱉는 불량 확률의 분포를 기록하세요. 어느 날부터 '불량 확률 50~70% 애매한 구간'의 예측이 늘어난다면, 모델이 확신을 잃고 있다는 신호입니다.


신뢰도 스코어의 평균을 추적한다. 정상 판정의 평균 신뢰도가 0.97에서 0.91로 미끄러졌다면, 아직 오탐이 늘기 전이라도 드리프트가 진행 중입니다. 정확도는 '결과'이고, 신뢰도는 '예고'입니다.


재확인율을 센다. 현장 작업자가 AI 판정을 뒤집은 비율(재확인율)이 주 단위로 올라가면, 모델과 현장의 간극이 벌어지고 있다는 증거입니다. 이 지표 하나만 잘 봐도 드리프트의 타이밍을 놓치지 않습니다.


드리프트는 막는 게 아니라 '보는' 겁니다. 보고 있으면 대응할 수 있고, 못 보면 어느 날 갑자기 무너집니다.


3. 재학습 루프 — 드리프트를 운영으로 흡수하기


드리프트를 알았다면, 이제는 운영의 문제입니다. 제가 쓰는 재학습 루틴은 이렇습니다.


주기적 재학습을 캘린더에 박는다. 분기 1회, 혹은 월 1회 — 주기는 라인의 변화 속도에 맞춥니다. '정확도가 떨어지면'이 아니라 '날짜가 되면' 재학습합니다. 떨어진 뒤에 움직이면 이미 늦습니다.


새 실측 데이터 + 합성 시나리오를 함께 업데이트한다. 재학습 때는 그 기간에 모은 실제 불량 데이터를 넣고, 새로 발견된 드리프트 요인(예: 바뀐 조명 조건, 신규 불량 유형)은 합성 파이프라인의 시나리오로 추가합니다. 2편의 '수집 → 합성 → 검증 → 다시 합성' 루프가 여기서도 돕니다.


모델을 버전으로 관리하고 롤백을 준비한다. 재학습한 모델이 오히려 나빠질 수 있습니다. 구 버전으로 즉시 되돌릴 수 있어야 현장의 신뢰가 깨지지 않습니다. 배포 전에는 2편의 파일럿 루틴을 짧게라도 다시 돌리세요.


합성 파이프라인을 끄지 않는다. 가장 흔한 실수가 이겁니다. 모델이 현장에 나갔다고 합성 환경을 정리해버리면, 드리프트가 왔을 때 처음부터 다시 만들어야 합니다. 합성 파이프라인은 '운영 자산'입니다. 살려두는 팀과 정리하는 팀의 차이는, 드리프트가 왔을 때 대응 속도의 차이입니다.


배포는 끝이 아니라 시작이다


합성 데이터는 '데이터가 없어서 못 한다'는 핑계를 없애줬고, 검증 루프는 '가상에서는 됐는데'라는 핑계를 없애줬습니다. 남은 핑계는 "처음엔 됐는데"입니다. 이걸 없애주는 게 드리프트 감시와 재학습 루프, 즉 운영입니다.


그래서 뭘 하면 되나 — 모델이 현장에 나가 있다면, 오늘 당장 예측 로그에 타임스탬프와 신뢰도 스코어가 남는지 확인하세요. 그 두 줄이 없으면 드리프트는 보이지 않고, 보이지 않는 건 관리할 수 없습니다. 시리즈 1편에서 데이터를 '만드는' 법을, 2편에서 '검증하는' 법을 다뤘다면, 3편의 결론은 이겁니다. 제조 AI의 수명은 훈련이 아니라 운영이 결정합니다.


관련 글: 디지털트윈의 진짜 엔진은 3D가 아니라 '데이터 수집'이다 — 합성 시대에도 수집이 여전히 필요한 이유.

728x90
728x90

'실시간'이라는 말의 함정


디지털트윈 프로젝트 발표 자리에서 "실시간으로 반영됩니다"라는 말을 수없이 들었습니다. 그런데 현장에 가보면 그 '실시간'이 기계의 현재 상태가 아니라 몇 초 전, 어떤 날은 몇 분 전의 상태인 경우가 많습니다.


디지털트윈의 3D 화면이 화려하면 화려할수록 이 간극은 잘 안 보입니다. 하지만 그 데이터로 "지금 이 기계가 안전한가?"를 판단해야 하는 순간, 지연된 데이터는 거짓말을 합니다. 정지한 기계를 돌아가고 있다고, 정상 온도를 과열이라고 보

여주죠.


시간축을 설계하는 3가지 요소


디지털트윈이 진짜 '실시간'이 되려면 화면을 그리기 전에 시간축을 설계해야 합니다. 현장 7년차인 제가 실제 구축 때 체크하는 요소는 세 가지입니다.


첫째, 샘플링 주기. 진동 데이터는 1초에 수백 번씩 샘플링해야 의미가 있지만, 탱크의 수위는 10초에 한 번이면 충분합니다. 신호마다 '이 데이터가 판단에 필요한 시간 해상도'가 다릅니다. 전부 1ms로 맞추면 네트워크가 죽고, 전부 1초로 맞추면 알람이 늦습니다.


둘째, 지연시간(latency) 예산. 센서에서 게이트웨이, 브로커, 처리 파이프라인, 화면까지 데이터가 지나가는 각 구간이 지연을 더합니다. 목적지별 예산을 정해야 합니다. "경광등 트리거는 100ms 이내, 대시보드는 1초 이내, 일간 리포트는 다음 날" 같은 식입니다. 전체를 '실시간'으로 묶는 순간 설계는 망가집니다.


셋째, 타임스탬프 동기화. 서로 다른 장비의 데이터를 "같은 시각"의 것으로 붙이려면 시계가 맞아야 합니다. NTP로 수백 ms 어긋난 시계끼리 데이터를 합치면, 인과관계가 뒤집힌 그래프가 그려집니다. "A가 B보다 먼저 이상했다"는 판단이 시계 오차 때문이었다면 현장에서 신뢰를 잃습니다.


그래서 뭘 하면 되나


신규 구축이라면 센서를 달기 전에 먼저 물어보세요. "이 데이터는 어디에, 언제까지 닿아야 하는가?" 이 질문에 답이 나오면 샘플링 주기와 지연 예산이 정해지고, 그제야 어떤 프로토콜(OPC UA·MQTT·Modbus)이 어울리는지가 정해집니다.


디지털트윈의 진짜 엔진은 3D 모델이 아닙니다. 데이터가 "지금"을 말하게 만드는 시간축 설계입니다. 화면이 예쁘다고 실시간이 되는 건 아닙니다.


관련 글: #124 "디지털트윈의 진짜 엔진은 3D가 아니라 '데이터 수집'이다" — 수집 단계(프로토콜 선택)에서 시간축 설계로 이어지는 심화편입니다.

728x90
728x90

"제품의 일생을 데이터 실로 꿰는 것." 오늘 아침 쇼츠 '제조AI 용어 사전 EP.2'의 한 문장 요약이다. 30초 쇼츠에서는 맛만 봤으니, 블로그에서는 7년차 현장 엔지니어 관점으로 제대로 풀어 보자. 디지털 스레드가 뭔지, 디지털 트윈과 뭐가 다른지, 왜 현장에서 필요한지, 그리고 어디서부터 시작하면 좋은지까지.

1. 디지털 스레드란 — 제품 평생 데이터의 실 한 가닥
디지털 스레드(Digital Thread)는 제품의 설계 → 생산 → 운영 → 유지보수 → 폐기까지 전 생애주기(Lifecycle)에 걸쳐 흩어진 데이터를 하나로 꿰는 개념이다. '스레드'는 실이라는 뜻. 설계 데이터(CAD 도면), 공정 데이터(MES 생산 기록), 운영 데이터(센서 로그), AS 데이터가 각자 다른 시스템에 갇혀 있으면, 같은 제품 얘기인데도 서로 다른 언어를 쓰는 셈이다. 스레드는 그걸 하나의 흐름으로 연결한다.
중요한 포인트 하나. 디지털 스레드는 기술 제품이 아니라 데이터 연결의 설계다. 특정 솔루션을 사면 끝나는 게 아니라, "우리 제품의 데이터가 어디에, 어떤 형식으로, 누구 손에 있는지"를 정리하는 작업부터 시작한다. 그래서 제조업의 디지털 전환에서 가장 먼저 묻는 질문이기도 하다: "스레드가 끊긴 지점이 어디냐고."
2. 디지털 트윈과의 관계 — 스레드가 있어야 트윈이 산다
이 둘을 헷갈리는 경우가 많다. 한 줄로 정리하면 이렇다.
- 디지털 스레드 — 비유: 실 — 역할: 생애주기 데이터의 연결·흐름
- 디지털 트윈 — 비유: 옷 — 역할: 특정 시점의 가상 복제 모델
디지털 트윈이 설비의 가상 복제라면, 디지털 스레드는 그 트윈을 계속 살아 있게 만드는 데이터의 공급선이다. 트윈은 스레드 없이는 초기 모델 한 번 만들고 끝나는 정적 모형이 된다. 반대로 스레드는 트윈이 없어도 의미가 있다 — 설계 변경이 생산 라인에 즉시 반영되거나, 현장 불량 데이터가 다음 설계에 피드백되는 식의 연결만으로도 가치가 생긴다.
현장에서 자주 보는 오해가 "디지털 트윈 만들었으니 끝"이다. 센서 데이터가 안 들어오는 트윈은 그냥 비싼 3D 뷰어다. 트윈의 품질은 스레드의 연속성이 결정한다.
3. 현장에서 스레드가 끊기는 지점들
7년 현장에서 본 스레드 단절의 대표 패턴 세 가지.
첫째, 설계와 생산의 단절. CAD 도면이 바뀌었는데 MES의 작업 지시서에는 옛날 버전이 남아 있다. PLM과 MES가 연동 안 되면, 설계 변경은 이메일이나 구두로 전달되고 현장에서는 구 버전 도면을 보고 작업한다. 이게 불량의 시작이다.
둘째, 생산과 운영의 단절. 라인에서 나온 품질 데이터가 설계팀에 안 돌아간다. "이 부품은 이렇게 가공하면 불량이 난다"는 현장의 지식이 데이터로 안 남고, 다음 제품 설계 때 같은 실수가 반복된다. 피드백 루프가 끊긴 거다.
셋째, 데이터 형식의 단절. 같은 온도 값인데 설계팀은 엑셀, 생산팀은 MES, 설비팀은 SCADA에 각각 다른 단위·다른 주기로 기록한다. 연결하려면 형식 통일부터다. 이게 의외로 가장 손이 많이 가는 작업이다.
이 셋을 보면 알겠지만, 디지털 스레드는 AI보다 먼저 데이터 거버넌스의 문제다. 누가, 어떤 형식으로, 얼마나 자주 기록할지가 정해져 있어야 실이 꿰인다.
4. 어디서부터 시작하면 좋을까
거창하게 PLM부터 바꾸지 말자. 작은 제품 하나, 작은 구간 하나로 시작하는 게 현장에서 통하는 순서다.
1. 제품 1종을 고른다 — 생애주기 데이터가 비교적 잘 남아 있는 대표 제품.
2. 데이터 지도를 그린다. 설계·생산·운영·AS 각 단계의 데이터가 어디에, 어떤 형식으로 있는지 목록화한다.
3. 끊긴 지점 1곳을 정한다. 보통은 "설계 변경이 생산에 늦게 반영됨" 같은 구체적 통증이 있다.
4. 그 지점만 연결하는 최소 스레드를 만든다. API 연동이든, 정형 파일 교환이든, 방식은 중요하지 않다. 일단 흐르게 만드는 게 먼저다.
5. 효과를 측정하고 다음 구간으로 넓힌다. 불량률·변경 반영 시간 같은 숫자로 증명해야 조직이 움직인다.
디지털 스레드는 "다 연결하자"가 아니라 "가장 아픈 곳부터 꿰자"는 전략이다. 실 한 가닥이 제대로 꿰이면, 그 다음 실은 훨씬 쉽게 꿰인다.
디지털 스레드는 멋진 신기술이 아니다. 제품에 관한 데이터가 끊기지 않고 흐르게 만드는, 지루하지만 결정적인 작업이다. 그 실이 있어야 디지털 트윈도 살고, 제조 AI도 학습할 데이터가 생긴다. 다음 EP에서는 '가상 커미셔닝(Virtual Commissioning)'을 다룬다. 쇼츠에서 30초로, 블로그에서 깊이 있게. 시리즈로 따라오면 제조AI 용어가 하나씩 내 것이 된다.
728x90
728x90

현장에 들어가면 가장 먼저 마주하는 풍경이 있습니다. 모니터 한쪽에 빨간 알람이 수백 건씩 쌓여 있고, 정작 "그래서 지금 뭐가 문제야?"라는 질문에는 아무도 답을 못 하는 장면이요.


7년차 현장 엔지니어로서 저는 이 장면을 수도 없이 봤습니다. 알람이 너무 많아서 알람이 무용지물이 되는 역설. 오늘은 현장에서 배운 '로그 설계' 습관 이야기를 해보려고 합니다. 기술을 자랑하려는 글이 아니라, 제가 실제로 써먹는 기준을 정리한 글입니

다.


알람은 '경보'가 아니라 '대화'다


처음 현장에 들어갔을 때 저는 설비가 고장 나면 로그를 "찾아보는" 사람이었다가, 어느 순간부터 로그가 "먼저 말을 걸어주는" 구조를 만들게 됐습니다.


현장 설비에서 나오는 데이터는 크게 세 종류입니다. 상태값(온도·진동·전류 같은 연속 데이터), 이벤트(기동·정지·모드 변경), 그리고 알람. 문제는 많은 공장이 이 세 가지를 같은 '알람 테이블'에 쏟아붓는다는 겁니다. 센서 통신 끊김 알림과 모터 과부하 정지가 같은 우선순위로 울리면, 작업자는 결국 둘 다 무시하게 됩니다.


제가 현장에서 적용하는 원칙은 단순합니다. "이 알람을 본 사람이 10분 안에 뭔가를 할 수 있는가?" 행동으로 이어지지 않는 알람은 로그로 격하합니다. 그리고 격하한 로그는 나중에 검색할 수 있게 태그만 정확히 붙여둡니다.


로그에 남겨야 할 '네 가지 필드'


현장에서 로그 테이블을 설계할 때, 저는 이 네 가지가 없으면 로그가 아니라 단순 기록이라고 봅니다.


1. 언제 — 밀리초 단위 타임스탬프 (설비끼리 시간이 어긋나면 상관 분석이 깨집니다)

2. 어디서 — 설비 ID + 센서 위치 + 공정 단계

3. 무엇이 — 알람 코드가 아니라 '측정값과 임계값'까지 함께 (예: 진동 4.2mm/s, 임계 3.5)

4. 그래서 어떻게 됐나 — 자동 정지했는지, 경고만 했는지, 무시됐는지


특히 네 번째를 빼먹는 현장이 많습니다. 알람이 울렸는데 아무 조치 없이 넘어간 기록이 쌓이면, 나중에 "예지정비를 하겠다"고 해도 학습 데이터가 쓰레기가 됩니다. 제조 AI를 하고 싶다면 로그 설계가 먼저입니다. AI는 좋은 데이터 위에서만 살아남습니다.


그래서 뭘 하면 되나 — 월요일 아침에 바로 할 수 있는 한 가지


당장 거창한 시스템 개편이 필요 없습니다. 지금 울리고 있는 알람 목록을 뽑아 "10분 안에 행동 가능한가?" 기준으로 한 번만 분류해 보세요. 아마 절반 이상이 격하 대상일 겁니다. 그걸 로그로 내리고, 남는 것만 진짜 알람으로 두는 것. 그게 현장 로그 설계의 시작입니다.


화려한 대시보드보다 먼저, 조용한 로그 테이블부터 손보는 게 제가 현장에서 배운 순서입니다.

728x90
728x90

MOU 하나로 끝날 뉴스가 아니다


2026년 10월 19일, 공간지능 기반 피지컬 AI 스타트업 로아이(ROAI)가 일본의 종합무역상사 도쿄무역그룹과 차세대 스마트제조 플랫폼 구축을 위한 업무협약(MOU)을 체결했다는 소식이 나왔다(와우테일, 2026-10-19). 로아이는 설계 데이터만으로 AI가 로봇의 경로와 동작을 스스로 결정하는 '원클릭 자율 제조 인프라'를 구현한 회사다. 현대자동차·기아·GM의 용접·검사 공정에서 생산 준비 시간과 인력 투입을 크게 줄였다는 것이 회사 측 설명이고, 최근 KB인베스트먼트·LB인베스트먼트·두산인베스트먼트 등으로부터 130억 원 규모의 시리즈 A 투자를 유치했다.


이번 협약의 구조도 흥미롭다. 도쿄무역그룹은 현지 제조업 네트워크를 활용해 일본 시장 개척·수요 발굴·데모 및 PoC(개념 검증)의 기획과 운영을 총괄하고, 로아이는 핵심 기술 솔루션과 평가용 라이선스, 기술 지원을 맡는다. "국내 제조 현장에서 입증된 솔루션을 일본 제조 생태계에 이식"하는 것이 목표다. 다시 말해, 한국 스마트팩토리 기술의 수출 계

약이다.


7년차 현장 엔지니어가 주목한 건 '수출'이 아니라 '경로 자동화'다


뉴스에서 내가 제일 오래 들여다본 문장은 이것이다. "설계 데이터만으로 AI가 로봇 경로와 동작을 스스로 결정한다."


현장에서 로봇 한 대를 세팅해 본 사람은 안다. 로봇 경로를 잡는 일(티칭·경로 설계)은 지루하고, 오래 걸리고, 사람에 크게 의존한다. 같은 용접 라인이어도 베테랑이 잡은 경로와 신입이 잡은 경로는 사이클 타임이 다르고, 불량률도 다르다. 이건 '기술'이 아니라 손의 기억에 가까운 암묵지였다. 그런데 로아이는 그 손의 기억을 설계 데이터에서 뽑아내는 자동화로 치환했다.


이게 중요한 이유는 제조 AI의 병목이 '모델'이 아니라 '현장의 문턱'에 있기 때문이다. 공장은 AI를 도입한 뒤에도 실제 쓰는 사람이 없으면 무용지물이다. 로봇 경로 자동화는 도입 문턱 자체를 낮춘다 — 현장 엔지니어가 AI를 '배우지 않아도' AI가 현장의 일을 해내게 만드는 방향이다.


일본은 왜 한국 기술을 사는가


좀 더 짚어볼 지점이 있다. 일본은 자동화의 종주국이다. 그런 나라의 제조 네트워크가 왜 한국 스타트업의 피지컬 AI를 들이는 걸까.


기사 속 구조를 다시 보자. 도쿄무역그룹은 '사업개발형 상사'로, 에너지·기계·자재·제조 등 산업 분야에서 글로벌 비즈니스를 전개한다. 즉, 기술을 사는 게 아니라 현장에 검증된 도입 속도를 사는 것이다. 현대차·기아·GM 현장에서 굴러본 실적, 130억 투자로 검증된 성장 동력, 그리고 상호운용성·시장 적합성을 함께 검증하겠다는 PoC 설계까지 — 일본 제조업이 원하는 건 화려한 데모가 아니라 '우리 공장에서 돌아가냐'는 답이다.


물론 냉정할 필요도 있다. MOU는 MOU일 뿐, 본계약이 아니다. 양사가 명시한 것도 "중장기 파트너십 가능성을 다각도로 탐색"이다. 하지만 방향은 분명하다. 스마트팩토리 기술의 게임이 '만드는 기술'에서 '현장에 검증된 기술'로 옮겨가고 있고, 그 검증의 통화가 된 회사가 국내 스타트업이라는 점. 이게 오늘 뉴스의 진짜 트렌드다.


그래서, 우리한테 뭘 남기는가


7년차 현장 엔지니어로서 한 줄로 정리하면 이렇다. "로봇을 가르치는 건 이제 사람의 손이 아니라 데이터고, 그 데이터의 가치는 '어디서 검증됐는가'로 결정된다."


그리고 '그래서 뭘 하면 되나'를 붙이면 — 현장에 있다면, 내가 잡은 경로·내가 고친 설비가 어떤 데이터로 남고 있는지부터 챙겨라. 암묵지가 데이터가 되는 시대에, 경험을 기록하지 않는 엔지니어는 자신의 가장 큰 자산을 방치하는 셈이다.


출처: 와우테일, 「로아이, 日 도쿄무역그룹과 스마트 제조 플랫폼 구축」(2026-10-19, 13:54 KST). 본문 수치는 모두 기사 인용.

728x90

+ Recent posts