
공장에 AI를 들이겠다고 하면 제일 먼저 막히는 지점이 있습니다. 모델이 아니라, 데이터입니다. 정확히는 '불량 데이터'입니다. 정상 데이터는 차고 넘치는데, 모델이 배워야 할 불량은 모자라거든요. 7년차 현장 엔지니어로서, 제조 AI 프로젝트가 멈추는 이유 1순위를 꼽으라면 저는 주저 없이 "불량이 안 나온다"를 듭니다.
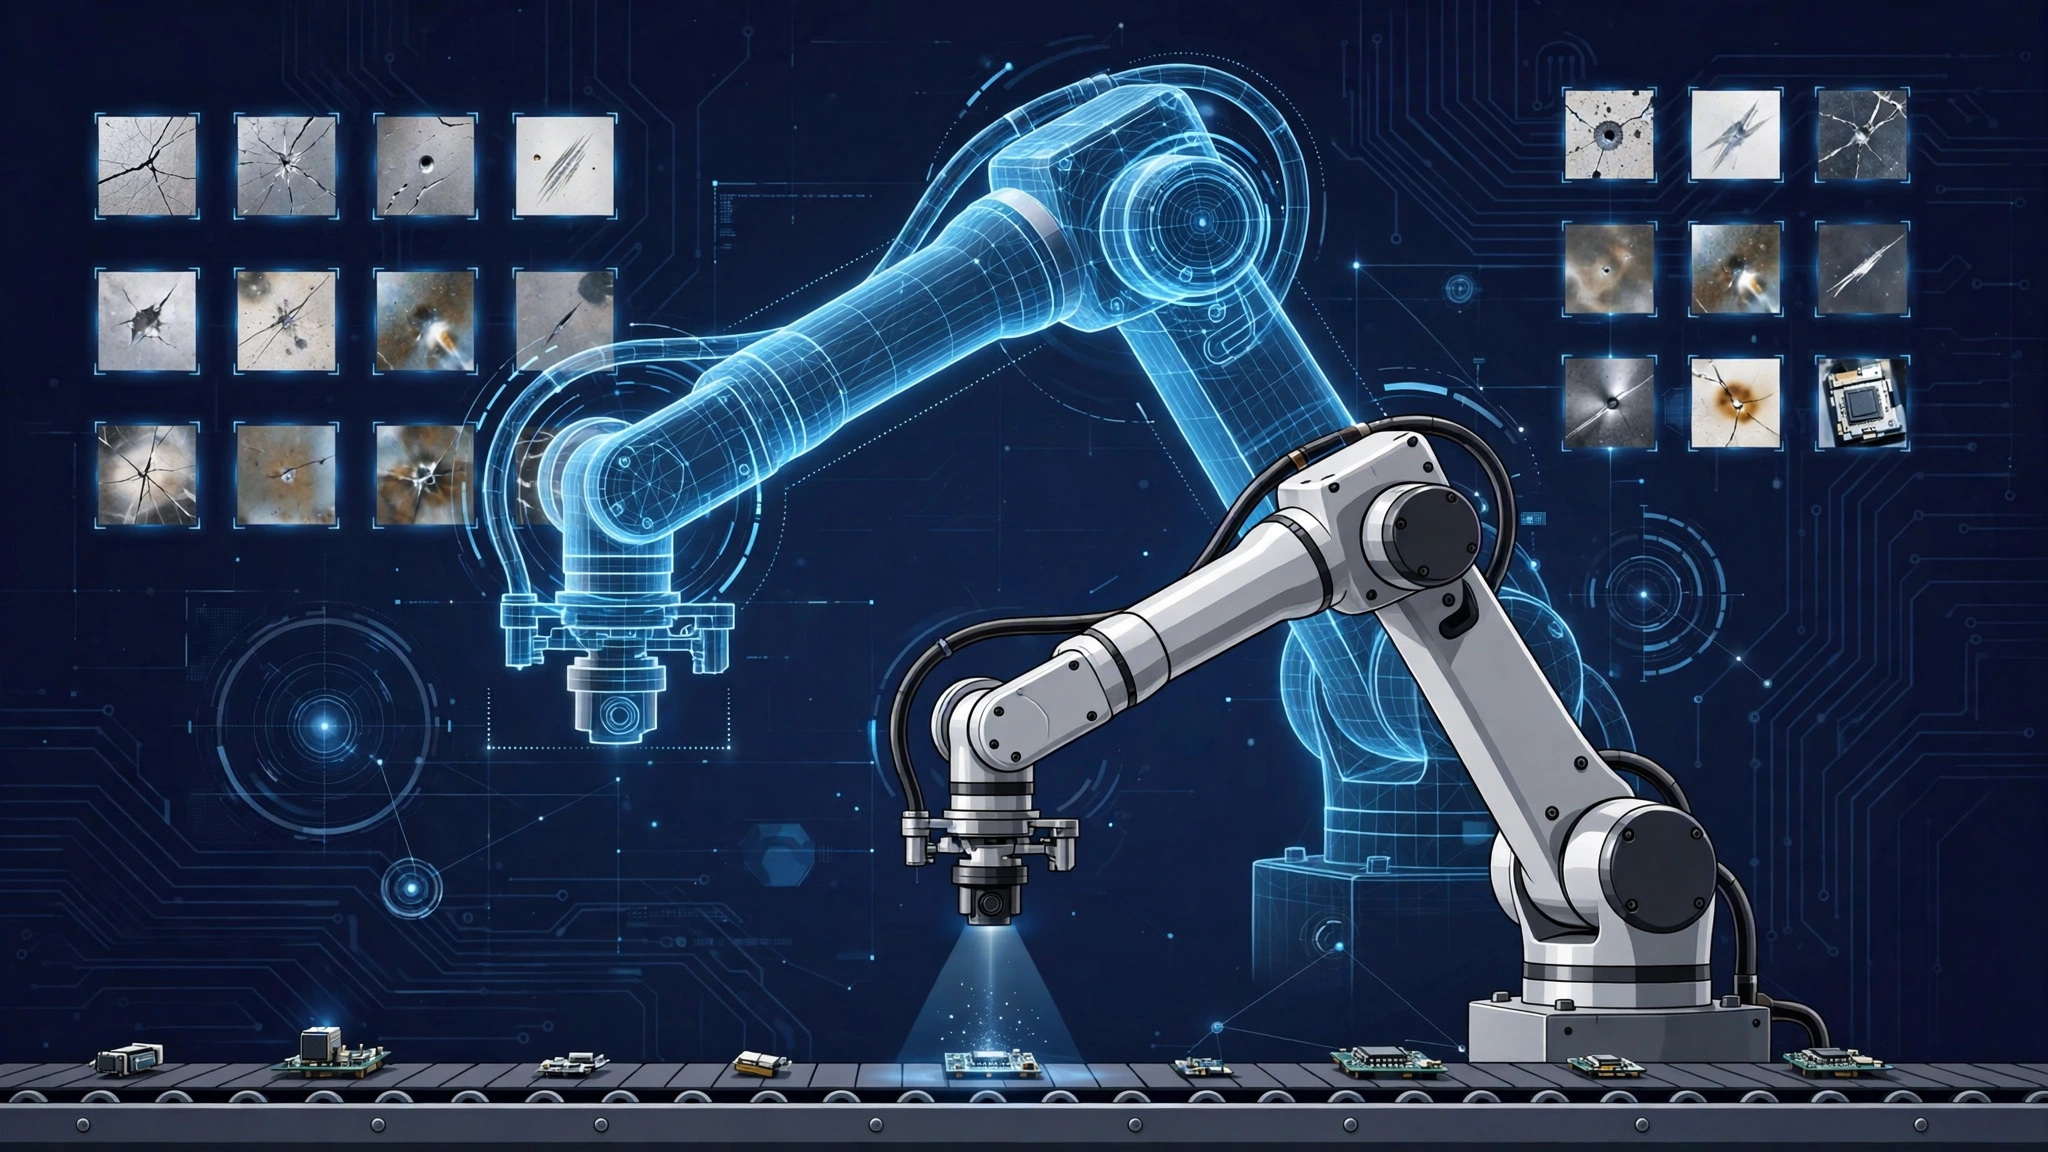
불량이 희귀 사건인 공장에서는 AI가 배울 게 없다
생산라인의 존재 이유는 불량을 안 만드는 겁니다. 하루에 수만 개를 찍어내도 불량은 몇 개, 심지어 0개입니다. 데이터 관점에서 보면 이건 치명적인 불균형입니다. 정상만 10만 장, 불량은 50장. 이렇게 학습한 모델은 "전부 정상"이라고 답하는 게 제일 안전한 선택이 됩니다. 정확도 99.9%라는 숫자 뒤에 숨어, 현장에서 정작 필요한 불량 판별은 못 하는 거죠.
게다가 불량은 매번 같은 얼굴로 오지 않습니다. 긁힘의 방향, 찍힘의 깊이, 조명 각도에 따라 수백 가지로 변합니다. 수집으로 커버하려는 건 밑 빠진 독에 물 붓기입니다. 이 한계를 뚫는 트렌드가 바로 '합성 데이터' — 현실에 없는 데이터를 만들어서 훈련하는 방식입니다.
데이터를 '수집'하는 시대에서 '만드는' 시대로
합성 데이터를 만드는 방법은 크게 세 가지입니다.
1. 디지털트윈에서 렌더링한다. 실제 설비의 디지털트윈에서 가상 불량 시나리오를 돌리고, 그 영상을 학습 데이터로 씁니다. BMW는 NVIDIA Isaac Sim에서 배송 로봇을 훈련하면서 도메인 랜덤화(domain randomization) 기반 합성 데이터를 생성합니다. 실제 같은 이미지를 수백만 장 뽑아내되, 조명·질감·각도를 무한히 바꿔가며 뽑는 방식입니다. 라인을 세우기 전 가상으로 돌려보는 가상 커미셔닝과 같은 맥락 — 그 트윈이 이번엔 AI의 교과서가 됩니다.
2. 조명·각도·질감을 무작위로 바꾼다. 시뮬레이션과 현실의 간극(sim-to-real gap)을 줄이는 핵심 기법입니다. 렌더링이 완벽할 필요는 없습니다. 오히려 다양한 조건을 무작위로 섞어 학습시키면, 모델은 '완벽한 이미지'가 아니라 '불량의 본질'을 배우게 됩니다.
3. 소량의 실제 불량에서 변형을 만든다. 생성형 AI로 실제 불량 50장을 수천 장으로 불립니다. 크랙의 방향을 바꾸고, 배경을 바꾸고, 조명을 바꿉니다. 실제 데이터의 '씨앗'은 살리고, 다양성은 합성으로 채우는 하이브리드 방식입니다.
그래도 합성은 만능이 아니다 — 현장의 검증 루프가 답이다
주의할 점이 있습니다. 합성 데이터로만 학습한 모델은 가상 세계에 최적화되기 쉽습니다. 실제 공장의 롱테일 불량 — 시뮬레이션에 넣지 못한 그 기묘한 불량 하나 — 앞에서 무너집니다. 그래서 저는 하이브리드를 씁니다. 실제 데이터로 기준선을 잡고, 합성 데이터로 다양성을 채우고, 마지막에는 반드시 현장 데이터로 검증합니다.
그리고 제일 중요한 건 이겁니다. "어떤 불량을 합성할지"는 AI 엔지니어가 아니라 현장 작업자가 정해야 합니다. 불량의 종류와 우선순위를 아는 건 현장의 도메인 지식이고, 그 지식 없이 만든 합성 데이터는 예쁜 쓰레기에 불과합니다. AI가 데이터를 만드는 시대에도, 무엇을 만들지는 여전히 사람이 정합니다.
그래서 뭘 하면 되나 — 불량 데이터 부족으로 막혀 있다면, 지금 모은 실제 불량 50장이라도 좋습니다. 그걸 씨앗 삼아 합성 데이터 파이프라인을 한 번 돌려보세요. 수집이 한계에 닿았다면, 다음 무기
는 생성입니다.관련 글: 디지털트윈의 진짜 엔진은 3D가 아니라 '데이터 수집'이다 — 수집으로 데이터를 모았다면, 다음 단계는 '만드는' 것입니다.
'인공지능 & 데이터 사이언스' 카테고리의 다른 글
| 배포한 AI 모델, 현장에서 버전이 꼬이기 전에 — 모델·데이터·프롬프트 3축 버전 관리 (0) | 2026.10.27 |
|---|---|
| 배포한 AI 모델, 현장에서 버전이 꼬이기 전에 — 모델·데이터·프롬프트 3축 버전 관리 (0) | 2026.10.25 |
| 모델이 바뀌어도 현장 AI는 살아남는다 — 프롬프트 위의 '규칙 레이어' 설계법 (0) | 2026.10.22 |
| 시뮬레이션에서 배운 AI, 공장에서 살아남는 법 — 합성 데이터 제조 AI의 현장 검증 3단계 (0) | 2026.10.20 |
| AI 데모는 됐는데 현장에서 안 되는 이유 — '재현성' 없이 굴리는 모델의 대가 (0) | 2026.10.20 |